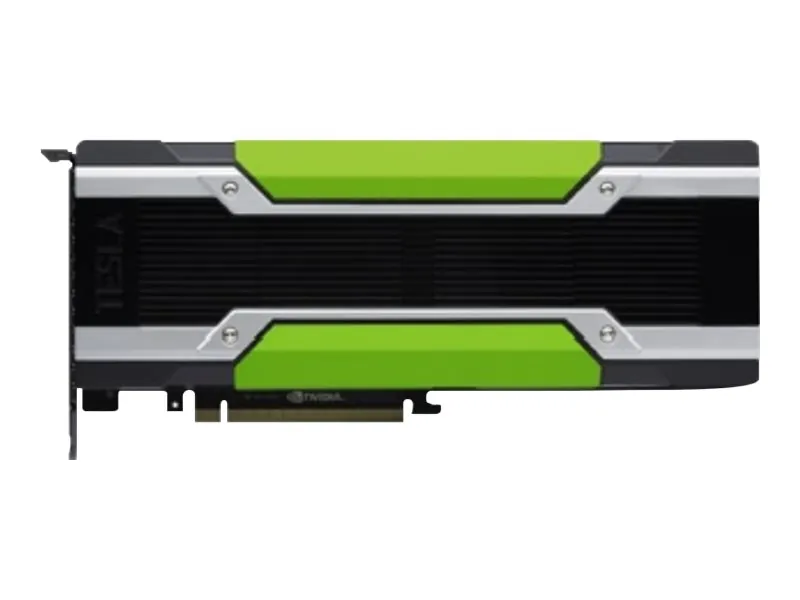
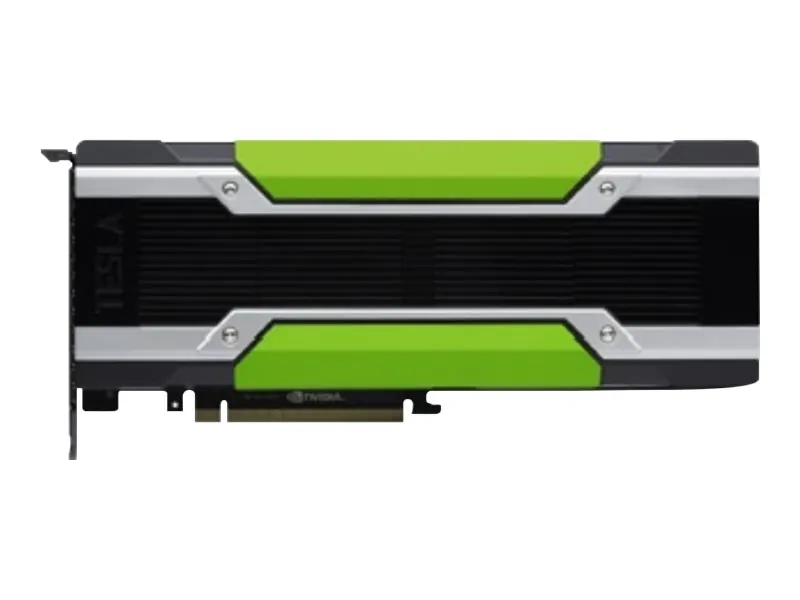
NVIDIA Tesla - GPU-Rechenprozessor - 4 GPUs - Tesla M10 - 32 GB GDDR5 - PCIe 3.0 - ohne Lüfter - für ThinkAgile VX3520-G Appliance 7Y94; ThinkSystem SD530 7X21; SR650
NVIDIA Tesla M10 als GPU-Rechenprozessor für Virtualisierungs-Server: Was steckt hinter der Lenovo-OEM-Karte?
Die Lenovo VA Tesla M10 GPU (7C57A02891) ist eine passive GPU-Karte auf Basis des NVIDIA Tesla M10 für den Einsatz in Rack-Servern der Lenovo ThinkSystem- und ThinkAgile-Baureihe. Als GPU-Rechenprozessor ohne aktive Kühlung ist sie ausschließlich für den Servereinbau konzipiert — nicht für Desktop-PCs oder Consumer-Hardware. Mit vier Maxwell-GPUs auf einer PCIe-3.0-Karte und einem Gesamtvideospeicher von 32 GB GDDR5 ist die M10 auf GPU-gestützte Virtual Desktop Infrastructure (VDI) ausgelegt: Sie erlaubt es, grafisch rechenintensive Desktop-Workloads über mehrere virtuelle Maschinen gleichzeitig zu beschleunigen. Die wichtigsten Merkmale auf einen Blick: vier eigenständige GPUs auf einer Karte, 32 GB GDDR5-Videospeicher insgesamt sowie lüfterloses (passives) Design zur nahtlosen Integration in das Serverkühlkonzept.
Leistung & GPU-Architektur der Tesla M10
Das technische Herzstück der Karte sind vier NVIDIA Maxwell-GPUs, die auf einer einzelnen PCIe-3.0-Karte vereint sind. Jede dieser vier GPUs ist eine vollständige Grafikverarbeitungseinheit mit eigenem Speicher, was die M10 grundlegend von typischen Consumer-Grafikkarten unterscheidet: Statt eines einzelnen leistungsstarken Chips bringt die Tesla M10 vier koordinierte, auf Parallelisierung optimierte GPUs mit, die unabhängig voneinander virtuellen Maschinen zugewiesen werden können.
Insgesamt stehen 2.560 CUDA-Kerne zur Verfügung — laut den vorliegenden Produktdaten sind es präzise 2.560 CUDA-Kerne über alle vier GPUs verteilt. Die Maxwell-Architektur (NVIDIA GPU-Generation Maxwell, auch als GM107/GM206-Klasse bekannt) ist zwar nicht mehr die neueste Generation, wurde jedoch von NVIDIA gezielt auf Effizienz und Parallelverarbeitung bei moderaten Taktfrequenzen ausgelegt. Für VDI-Workloads, bei denen viele Benutzer gleichzeitig grafisch beschleunigte virtuelle Desktops nutzen, ist diese Charakteristik vorteilhafter als eine einzelne Hochleistungs-GPU mit weniger parallelisierbaren Ressourcen.
Die Leistungsaufnahme beträgt laut Hersteller 225 Watt im Betrieb. Dieser Wert ist bei der Serverplanung entscheidend: Das Rechenzentrum muss die entsprechende Stromversorgung und Kühlkapazität für diese TDP bereitstellen. Da die Karte passiv gekühlt wird, übernimmt das Servergehäuse selbst die Wärmeabfuhr — die kompatiblen Systeme (ThinkSystem SD530, SR650, ThinkAgile VX3520-G) sind konstruktiv darauf ausgelegt.
Videospeicher: 32 GB GDDR5 auf vier GPUs verteilt
Die 32 GB GDDR5 SDRAM sind gleichmäßig auf die vier GPUs aufgeteilt — jede GPU verfügt damit über 8 GB eigenen Videospeicher. Dieser Wert ist für VDI-Deployments eine praxisrelevante Größe: Je mehr Videospeicher pro GPU vorhanden ist, desto mehr gleichzeitige Benutzer oder speicherintensivere virtuelle Desktops lassen sich bedienen. GDDR5 bietet gegenüber älterem GDDR3 eine deutlich höhere Speicherbandbreite, was bei parallelen Grafikoperationen vieler VMs direkt in die Skalierbarkeit einzahlt.
Wichtig für die Planung: Der Videospeicher ist nicht dynamisch zwischen den vier GPUs teilbar. Jede VM, die einer bestimmten physischen GPU-Partition zugewiesen wird, arbeitet mit dem Speicher dieser GPU. Dies hat Auswirkungen auf das Hypervisor-Scheduling und sollte bei der Dimensionierung des VDI-Stacks berücksichtigt werden.
Passivkühlung: Warum kein Lüfter?
Die Entscheidung für ein lüfterloses, passiv gekühltes Design ist bei Server-GPUs kein Kompromiss, sondern eine bewusste Architekturentscheidung. Server-Chasses wie der ThinkSystem SD530 oder SR650 verfügen über eigene, zentral gesteuerte Hochleistungslüfter, die einen definierten Luftstrom durch das gesamte Gehäuse erzeugen. Eine zusätzliche Eigenkühlung der GPU-Karte wäre hier kontraproduktiv: Sie würde den geregelten Luftstrom des Servers stören, zusätzliche Geräuschquellen einbringen und im schlimmsten Fall thermische Interferenzen verursachen.
Das passive Design bedeutet jedoch auch: Diese Karte ist ausschließlich für Server mit ausreichend dimensioniertem Gehäuse-Airflow geeignet. Der Einbau in Desktop-PCs, Consumer-Tower oder Server ohne ausreichenden Luftdurchsatz würde zu Überhitzung und Systeminstabilität führen. Die Kompatibilitätsliste des Herstellers — ThinkAgile VX3520-G, ThinkSystem SD530 und SR650 — definiert die validierten Betriebsumgebungen.
PCIe 3.0-Schnittstelle: Einordnung und Praxisrelevanz
Die Karte kommuniziert über PCI Express 3.0 mit dem Host-System. PCIe 3.0 x16 bietet eine theoretische Bandbreite von bis zu 16 GB/s in jede Richtung — für VDI-Workloads, bei denen die GPU primär fertig gerenderte Frames über das Netzwerk an Remote-Clients sendet (statt große Datenmengen in Echtzeit zwischen CPU-RAM und GPU-VRAM zu transferieren), ist PCIe 3.0 in der Praxis nicht der limitierende Faktor. Die Entscheidung gegen PCIe 4.0 ist in diesem Kontext also keine Schwäche, sondern spiegelt die ursprüngliche Zielstellung des Tesla M10 wider.
Kompatible Systeme und Einsatzbereiche
Laut Hersteller ist die Lenovo VA Tesla M10 GPU für folgende Systeme entwickelt und validiert worden:
- Lenovo ThinkAgile VX3520-G Appliance (7Y94) — eine hyperkonvergente Infrastruktur-Appliance, typischerweise mit VMware vSAN betrieben. Die GPU-Erweiterung ermöglicht hier grafisch beschleunigten virtuellen Desktops innerhalb des HCI-Stacks.
- Lenovo ThinkSystem SD530 (7X21) — ein 0,5-Höheneinheiten-Blade-Server, der in 2U-Chassis betrieben wird. Aufgrund des kompakten Formfaktors ist das passive Kühlkonzept hier besonders relevant.
- Lenovo ThinkSystem SR650 — ein 2U-Rack-Server der Enterprise-Klasse, der im Rechenzentrum als Standard-Plattform für VDI-Workloads weit verbreitet ist.
Der Einsatz außerhalb dieser validierten Systeme liegt außerhalb der Herstellerempfehlung. Wer die Karte in anderen Rack-Servern betreiben möchte, sollte die thermischen und elektrischen Anforderungen sorgfältig prüfen und beachtet, dass dann kein Lenovo-Support für die Kombination besteht.
Ideal für diese Einsatzbereiche
- Virtual Desktop Infrastructure (VDI) mit GPU-Beschleunigung: Die vier unabhängigen Maxwell-GPUs mit je 8 GB GDDR5 sind exakt für VDI-Szenarien konzipiert, bei denen viele Nutzer gleichzeitig grafisch beschleunigte virtuelle Desktops benötigen. Die Aufteilung auf vier separate GPUs ermöglicht eine granulare Zuweisung von GPU-Ressourcen auf virtuelle Maschinen — etwa über NVIDIA GRID-Technologie (heute NVIDIA Virtual GPU, vGPU), sofern die entsprechenden Lizenzen vorhanden sind.
- GPU-gestütztes Remote-Rendering für Enterprise-Desktops: In Szenarien, wo Mitarbeitende über Thin Clients oder Remote-Desktop-Protokolle auf ihre virtuellen Desktops zugreifen und dabei grafikintensive Anwendungen nutzen (z. B. komplexe Dashboards, 2D-CAD-Viewer, GIS-Applikationen), liefert die M10 die nötige GPU-Kapazität servereitig. Dies entlastet die Endgeräte vollständig von der Grafikverarbeitung.
- Hyperkonvergente Infrastrukturen mit grafischen Workloads (ThinkAgile VX3520-G): In HCI-Umgebungen, die auf VMware-Technologie basieren, erlaubt die validierte Integration in die ThinkAgile VX3520-G Appliance eine nahtlose Erweiterung bestehender vSAN-Cluster um GPU-Kapazität, ohne separate dedizierte GPU-Server einführen zu müssen.
- Laborumgebungen und Test-/Entwicklungsinfrastrukturen: Für Entwicklungsteams, die grafisch beschleunigte virtuelle Arbeitsplätze in isolierten Umgebungen bereitstellen, bietet die M10 eine kosteneffiziente Basis im Vergleich zu neueren Pascal- oder Turing-basierten Server-GPUs — insbesondere wenn die Workloads die Maxwell-Architektur nicht über ihre Fähigkeiten hinaus belasten.
Ausdrücklich nicht geeignet: Die Tesla M10 ist keine Karte für KI-Training oder Inferenz mit modernen Large Language Models — dafür fehlen sowohl die Tensor Cores (die erst mit der Volta-Architektur eingeführt wurden) als auch ausreichend VRAM pro GPU-Partition. Ebenso ist sie nicht für Consumer-Gaming oder als Workstation-GPU in Desktop-PCs geeignet, da das passive Kühldesign zwingend einen definierten Server-Airflow voraussetzt.
Häufige Fragen zur Lenovo Tesla M10 GPU (7C57A02891)
Kann die Tesla M10 in jeden PCIe-3.0-kompatiblen Server eingebaut werden?
Laut Hersteller ist die Karte ausschließlich für drei spezifische Lenovo-Systeme entwickelt und validiert: ThinkAgile VX3520-G Appliance (7Y94), ThinkSystem SD530 (7X21) und ThinkSystem SR650. Da die Karte passiv (ohne eigene Lüfter) gekühlt wird, ist sie auf den definierten Luftstrom des Servergehäuses angewiesen. Der Einbau in andere Server oder Desktop-Systeme liegt außerhalb der Herstellerempfehlung und kann zu thermischen Problemen führen.
Wie viele virtuelle Desktops kann die Tesla M10 gleichzeitig bedienen?
Eine konkrete Angabe zur maximalen Anzahl gleichzeitiger virtueller Desktops ist in den vorliegenden Produktdaten nicht enthalten und hängt stark vom gewählten VDI-Profil (Speicher-, Rechen- und Bandbreitenzuweisung pro VM) sowie der eingesetzten Virtualisierungssoftware und den dazugehörigen NVIDIA vGPU-Lizenzen ab. Als Orientierung: Mit 32 GB Gesamtspeicher auf vier GPUs (je 8 GB pro GPU) und 2.560 CUDA-Kernen lassen sich typischerweise viele gleichzeitige Leichtlast-VDI-Sitzungen betreiben, doch exakte Skalierungswerte sollten anhand eines Sizing-Tools oder einer NVIDIA-VDI-Referenzarchitektur ermittelt werden.
Unterstützt die Karte NVIDIA vGPU (früher NVIDIA GRID)?
Die Tesla M10 ist eine Server-GPU aus der NVIDIA-Tesla-Linie, die generell für vGPU-Szenarien ausgelegt ist. Ob und welche vGPU-Profile mit dieser spezifischen Lenovo-OEM-Version (7C57A02891) in den validierten Systemen unterstützt werden, hängt von den eingesetzten Treiber-Versionen und den erworbenen NVIDIA vGPU-Softwarelizenzen ab. Hierzu empfehlen wir die Rücksprache mit Lenovo oder NVIDIA, da diese Informationen nicht Bestandteil der vorliegenden Produktspezifikation sind.
Warum hat die Karte keinen Lüfter?
Das passive (lüfterlose) Design ist eine bewusste Designentscheidung für den Servereinbau. Rack-Server wie der ThinkSystem SR650 oder SD530 verfügen über intern gesteuerte Hochleistungslüfter, die einen definierten Luftstrom durch das Chassis erzeugen. Eigene Lüfter auf der GPU-Karte würden diesen kontrollierten Airflow stören. Das passive Design setzt allerdings voraus, dass der Server den thermischen Anforderungen der 225-Watt-TDP gerecht wird — weshalb der Einbau ausschließlich in den validierten Systemen empfohlen wird.
Ist die Maxwell-Architektur noch zeitgemäß?
NVIDIA Maxwell ist nicht mehr die aktuelle Servergeneration — neuere Architekturen wie Volta, Ampere oder Hopper bieten Tensor Cores für KI-Workloads und deutlich höhere Rechenleistung. Für klassische VDI-Anwendungsfälle, bei denen grafisch beschleunigte virtuelle Desktops auf Basis von OpenGL oder DirectX bereitgestellt werden, liefert die Maxwell-basierte M10 jedoch nach wie vor ausreichende Leistung. Wer moderne KI-Inferenz, Deep-Learning-Training oder Ray Tracing benötigt, sollte zu einer aktuelleren NVIDIA-Server-GPU greifen.
Welche Leistungsaufnahme muss das Rechenzentrum für die Tesla M10 einplanen?
Laut Hersteller beträgt die Leistungsaufnahme im Betrieb 225 Watt. Bei der Planung von Stromversorgung und Kühlung im Rechenzentrum muss dieser Wert zusätzlich zur Basisleistungsaufnahme des jeweiligen Host-Servers berücksichtigt werden. Das Netzteil des Servers muss ausreichend Headroom für diese zusätzliche Last bieten.
Allgemein
Produktdatenblatt (PDF)
Link
Hinweise zu den Produktangaben: Diese Produktdarstellung richtet sich ausschließlich an gewerbliche Abnehmer:innen (Unternehmer:innen iSv § 14 BGB). Alle Angaben zu Spezifikationen, Verfügbarkeit und Lieferzeiten sind freibleibend und unverbindlich; sie stellen kein verbindliches Angebot dar. Maßgeblich werden Leistungsumfang und Konditionen erst mit unserer Auftragsbestätigung. Abbildungen können vom tatsächlichen Produkt abweichen. Hersteller-, Produkt- und Markennamen sind Eigentum der jeweiligen Inhaber:innen und dienen ausschließlich der Beschreibung, eine Markenrechtsgestattung wird hierdurch nicht erteilt. Druckfehler, Irrtümer und Zwischenverkauf bleiben vorbehalten.
Alle Preise verstehen sich, sofern nicht anders gekennzeichnet, in Euro zzgl. der gesetzlichen Umsatzsteuer (derzeit 19 %) und zzgl. Versandkosten. Es gelten ausschließlich unsereAGBin der zum Zeitpunkt der Bestellung jeweils gültigen Fassung.
Beratung, Garantie und Betreuung
Garantieerweiterung
Herstellergarantie verlängern oder auf Vor-Ort-Service erweitern. Passende Servicepakete für Lenovo, HP und Apple findet ihr in der Kategorie Garantie & Service.
Eingerichtet und betreut geliefert
Auf Wunsch kommt das Gerät mit Microsoft 365, SentinelOne Endpoint-Schutz und Backup eingerichtet an, mit laufender Betreuung ab 199,95 € pro Mitarbeitenden und Monat.
Projekt- und Mengenpreise
Ab 5 Stück oder für Rollouts erstellen wir ein Angebot mit Projektpreis, Lieferplan und Vor-Ort-Einrichtung in Rostock und bundesweit.
Passende Kategorien und Marke
Ähnliche Produkte
BlueOptics SFP28-25G-ER | 25Gbps Single-Mode | 40km Reichweite
297,00 €
CBO BlueOptics SFP28 AOC-Kabel | 50m Ubiquiti kompatibel | 25 Gbit/s
171,00 €
BLUEOPTICS SFP28-AOC-50M | 25 Gbit/s AOC Kabel | 50m SFP28
165,00 €
CBO BlueOptics SFP28 AOC Kabel | 30m Ubiquiti kompatibel | 25 Gbit/s
140,00 €
CBO SFP28-AOC-30M | 30m AOC Kabel | SFP28 zu SFP28
132,00 €
CBO SFP28-AOC-25M | 25m AOC Kabel | 25 Gbit/s SFP28 zu SFP28
130,00 €
CBO BlueOptics SFP28 AOC-Kabel | 20m Ubiquiti kompatibel | 25 Gbit/s
120,00 €
BLUEOPTICS SFP28-AOC-20M | 20m Active Optical Cable | SFP28 zu SFP28
110,00 €